Wer seine Inhalte vom KI-Training ausnehmen wollte, musste bisher mehrere Kennungen pflegen. OpenAI nutzt „GPTBot“, Google „Google-Extended“, Bing eigene Angaben wie „NoArchive“ und „NoCache“. Das soll sich ändern. Am 30. Oktober 2026 haben Google, Microsoft und OpenAI zugesagt, eine gemeinsame Regel zu beachten.
Warum bisher so viel Handarbeit nötig war
Die robots.txt regelt den Abruf von Seiten, nicht deren Nutzung. So beschrieb es Googles Gary Illyes erst fünf Tage vor der Ankündigung. Dazu kommt: Googles Parser wertet nur „User-agent“, „Allow“, „Disallow“ und „Sitemap“ aus. Daran sind auch Cloudflares „Content Signals“ gescheitert.
Die neue Zeile
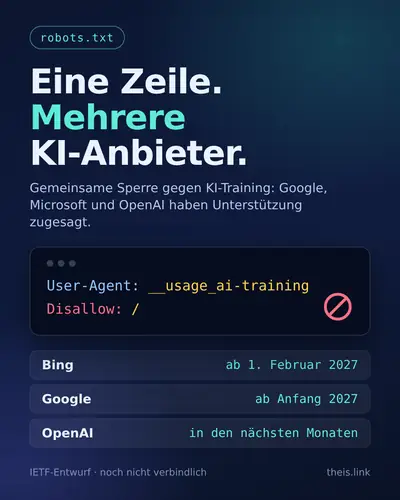
Und was ändert sich jetzt? Der Entwurf stammt von Kevin Kelley, Mitarbeiter von Anthropic. Seit dem 30. Oktober liegt er der IETF-Arbeitsgruppe „AI Preferences“ vor. Er führt eine gemeinsame Kennung ein, die wie ein Crawler-Name in der robots.txt steht:
User-Agent: __usage_ai-training
Disallow: /
Ein Disallow bedeutet: Die Inhalte sollen nicht in das Training generativer KI-Modelle fließen. Mit „Allow“ lassen sich Verzeichnisse wieder freigeben, etwa ein Pressebereich. Eine Sperre für „User-Agent: *“ zählt ausdrücklich nicht als Widerspruch. Ältere Parser überspringen die Gruppe wie jeden unbekannten Crawler-Namen. Das schadet also nicht.
Wer wann mitmacht
Bing beachtet die Kennung ab dem 1. Februar 2027, Google ab Anfang 2027, OpenAI in den kommenden Monaten. Die bisherigen Regeln für OpenAI-Crawler gelten weiter.
Google: Fehlt ein eigener Eintrag für „Google-Extended“, behandelt Google den gemeinsamen Widerspruch wie eine Sperre dieser Kennung. „Google-Extended“ regelt neben dem Gemini-Training auch, ob Inhalte als Grundlage für Antworten der Gemini-Apps dienen. Ranking und Aufnahme in die Suche bleiben unberührt. Für „AI Overviews“ und „AI Mode“ ist weiter der Schalter in der Search Console zuständig.
Microsoft: Bei Bing sind Training und „Grounding“ getrennt. Grounding heißt: Seiten dienen als Grundlage für KI-Antworten. Das Training lässt sich per robots.txt oder je Seite sperren. Das Grounding geht nur je Seite, per Meta-Tag oder HTTP-Header. Die Stufe „DisallowExtended“ erlaubt es nur in Microsofts eigenen Angeboten wie Copilot, nicht in Diensten für Dritte. Und die alten Angaben? „NoArchive“ und „NoCache“ zählen bei Bing ab dem 1. März 2027 nicht mehr als Widerspruch.
Einordnung
In Deutschland regelt § 44b des Urheberrechtsgesetzes das Text und Data Mining: Frei zugängliche Werke dürfen kopiert werden, solange sich der Rechteinhaber das nicht vorbehalten hat. Online wirkt ein solcher Vorbehalt nur in maschinenlesbarer Form. Google verweist auf den EU-Verhaltenskodex für KI-Modelle mit allgemeinem Verwendungszweck, der die robots.txt als wichtigsten Weg dafür anerkennt. Die EU-Datenschützer verlangen von KI-Entwicklern ohnehin, Websites mit einer Sperre in der robots.txt auszulassen.
Verbindlich ist der Entwurf nicht. Er kann sich bis zum Standard noch ändern. Lizenzen oder Zahlungen begründen die neuen Angaben laut Microsoft ebenfalls nicht.
Was jetzt zu tun ist
- Bestehende Sperren für „GPTBot“ oder „Google-Extended“ behalten
- Die gemeinsame Kennung ergänzen
- Bing-Angaben bis zum 1. März 2027 umstellen – den Vorbehalt gegen Grounding zusätzlich in den Bing Webmaster Tools
- Für Links in Antworten der Gemini-Apps „Google-Extended“ ausdrücklich erlauben
Die virtuelle robots.txt von WordPress lässt sich etwa mit „Yoast SEO“ oder „Rank Math“ bearbeiten.
Fazit
Dass drei große Anbieter am selben Tag zusagen, ist ungewöhnlich. Weniger Handarbeit – ja. Geld für die Inhalte – nein. Eine Zeile mehr kostet dafür nichts … und schaden soll sie heute auch nicht.
Quelle: Dr. Web – Google, Bing und OpenAI wollen eine gemeinsame robots.txt-Regel gegen KI-Training beachten (31. Oktober 2026)